Agents vocaux IA en production : 8 leçons pour battre la latence sans sacrifier l'intelligence
En vocal, deux secondes de silence suffisent à casser l'appel — et presque chaque milliseconde gagnée vous coûte de l'intelligence. Huit principes d'architecture standards : WebRTC, choix de pipeline, taxe du thinking, prompt optimization, génération préemptive, workers asynchrones, compaction et fallback réchauffé.
Pourquoi le vocal ne pardonne pas comme le texte
Appelant : « Est-ce que je peux déplacer mon rendez-vous à jeudi matin ? » (1,2 seconde de silence) Appelant : « Allô ? Vous êtes encore— » Agent : « Bien sûr, je vérifie jeu— » (L’agent détecte l’interruption, annule sa réponse et retombe dans le silence. Clic.)
Dans un chat texte, deux secondes d’attente passent inaperçues : trois petits points qui rebondissent achètent toute la patience du monde. Au téléphone, ce même vide sonne comme une ligne coupée. Passé une demi-seconde à une seconde de silence, votre interlocuteur teste instinctivement la connexion, parle par-dessus la première syllabe que votre modèle vient tout juste de prononcer, déclenche une boucle d’interruption et finit par raccrocher.
Mais dès qu’on part à la chasse aux millisecondes, on frappe la tension fondamentale des agents vocaux : presque chaque optimisation de latence se paie en intelligence brute.
Voici 8 principes d’architecture essentiels — du transport réseau jusqu’à la vingtième minute d’un appel mouvementé — pour rester rapide sans transformer votre agent en script rigide.
1. Commencer par le réseau : WebRTC sur le last mile, WebSockets dans le datacenter
La plupart des tutoriels de fournisseurs IA branchent directement le navigateur au modèle via WebSockets. Sur une connexion fibre au bureau, ça tourne comme un charme. Puis un vrai appelant entre dans un ascenseur sur une 4G instable, et l’audio part en vrille.
Head-of-Line blocking : TCP gèle tout le flux en attendant la retransmission.
La trame perdue est compensée (PLC) ; la suite de la phrase joue sans blocage.
La solution repose sur une séparation réseau bien connue, détaillée dans Voice AI & Voice Agents: An Illustrated Primer ainsi que dans les documentations de Pipecat et LiveKit :
- WebRTC sur le last mile (appareil ↔ serveur média). Sur réseau mobile ou Wi-Fi saturé, la perte de paquets est normale. Comme les WebSockets passent sur TCP, un seul paquet perdu force une retransmission et déclenche du head-of-line blocking : toutes les trames audio suivantes restent bloquées en file d’attente, créant des coupures suivies d’un flot accéléré. WebRTC transporte plutôt l’audio sur UDP (
RTP/SRTP), en tolérant ou masquant les trames tardives sans jamais geler la conversation. En prime, vous obtenez nativement les jitter buffers adaptatifs, la compression vocale Opus, l’annulation d’écho (AEC) et la réduction de bruit des navigateurs, ainsi que la traversée NAT (ICE/STUN/TURN). - WebSockets côté serveur (orchestrateur ↔ APIs de modèles). Une fois l’audio arrivé dans votre infrastructure cloud, le trafic entre votre backend et les fournisseurs de STT, LLM ou TTS circule sur des réseaux de datacenter stables, à perte quasi nulle. Dans ce contexte, TCP se comporte impeccablement et les WebSockets restent simples et efficaces.
2. Choisir son pipeline : Speech-to-Speech ou STT → LLM → TTS ?
La première fois qu’on entend un modèle speech-to-speech natif comme OpenAI Realtime (gpt-realtime) ou Gemini Live, on a l’impression d’entendre le futur. La prosodie, les rires, le rythme naturel et la faible latence brute bluffent immédiatement.
Mais dès qu’on sort de la conversation libre, leur terrain de jeu se rétrécit. Sur un parcours métier exigeant — un agent infirmier de triage, un interviewer RH structuré ou un conseiller soumis à des règles de conformité — ces modèles end-to-end restent moins fiables que des LLM texte dédiés pour respecter des consignes strictes, tenir un état déterministe et passer des évaluations reproductibles.
| Critère | Speech-to-Speech (Realtime / Gemini Live) | Pipeline (STT → LLM → TTS) |
|---|---|---|
| Prosodie & naturel | Expressivité audio native | Très bonne avec TTS en streaming |
| Latence brute | Minimale par défaut | Rapide via streaming + préemptif |
| Logique métier complexe | En retrait sur les règles strictes | Plein contrôle d'un LLM dédié |
| Évals & metaprompting | Plus difficile à auditer et optimiser | Transcripts clairs + optimisation de prompts |
| Cas d'usage idéal | Accueil simple, FAQ, conversation légère | Triage clinique, entrevue RH, conformité |
« Je veux réserver le 18 janvier… [pause 600 ms] …euh non, le 18 février. »
Dès que la rigueur compte, passez sur un pipeline modulaire STT → LLM → TTS. En plus de garder accès aux meilleurs LLM rapides et aux tests sur transcripts, vous débloquez un levier UX majeur : la détection sémantique de tour de parole (comme le Turn Detector de LiveKit ou Smart Turn de Pipecat).
Un simple détecteur de silence (VAD) coupe la parole dès qu’un humain reprend son souffle. Un détecteur sémantique lit le transcript et les indices vocaux en continu pour distinguer un « Euh… laissez-moi vérifier mon agenda… » d’une vraie fin de phrase.
3. Choisir un modèle rapide, puis payer la « taxe du thinking »
Pour évaluer la vitesse d’un LLM en vocal, deux métriques jouent des rôles très différents :
- Le Time to First Token (TTFT) dicte la vitesse perçue : c’est le délai avant que l’appelant n’entende le tout premier mot.
- Le débit (tokens/seconde) doit simplement rester confortablement au-dessus du rythme de la parole et du streaming TTS pour éviter tout bégaiement en milieu de phrase.
Le piège, c’est de se fier aux classements généraux sans regarder le mode de raisonnement. Sur Artificial Analysis, réglez le « thinking effort » sur low — ou coupez complètement la réflexion — pour voir ce qu’un modèle vaut vraiment quand on lui retire le luxe de réfléchir longtemps.
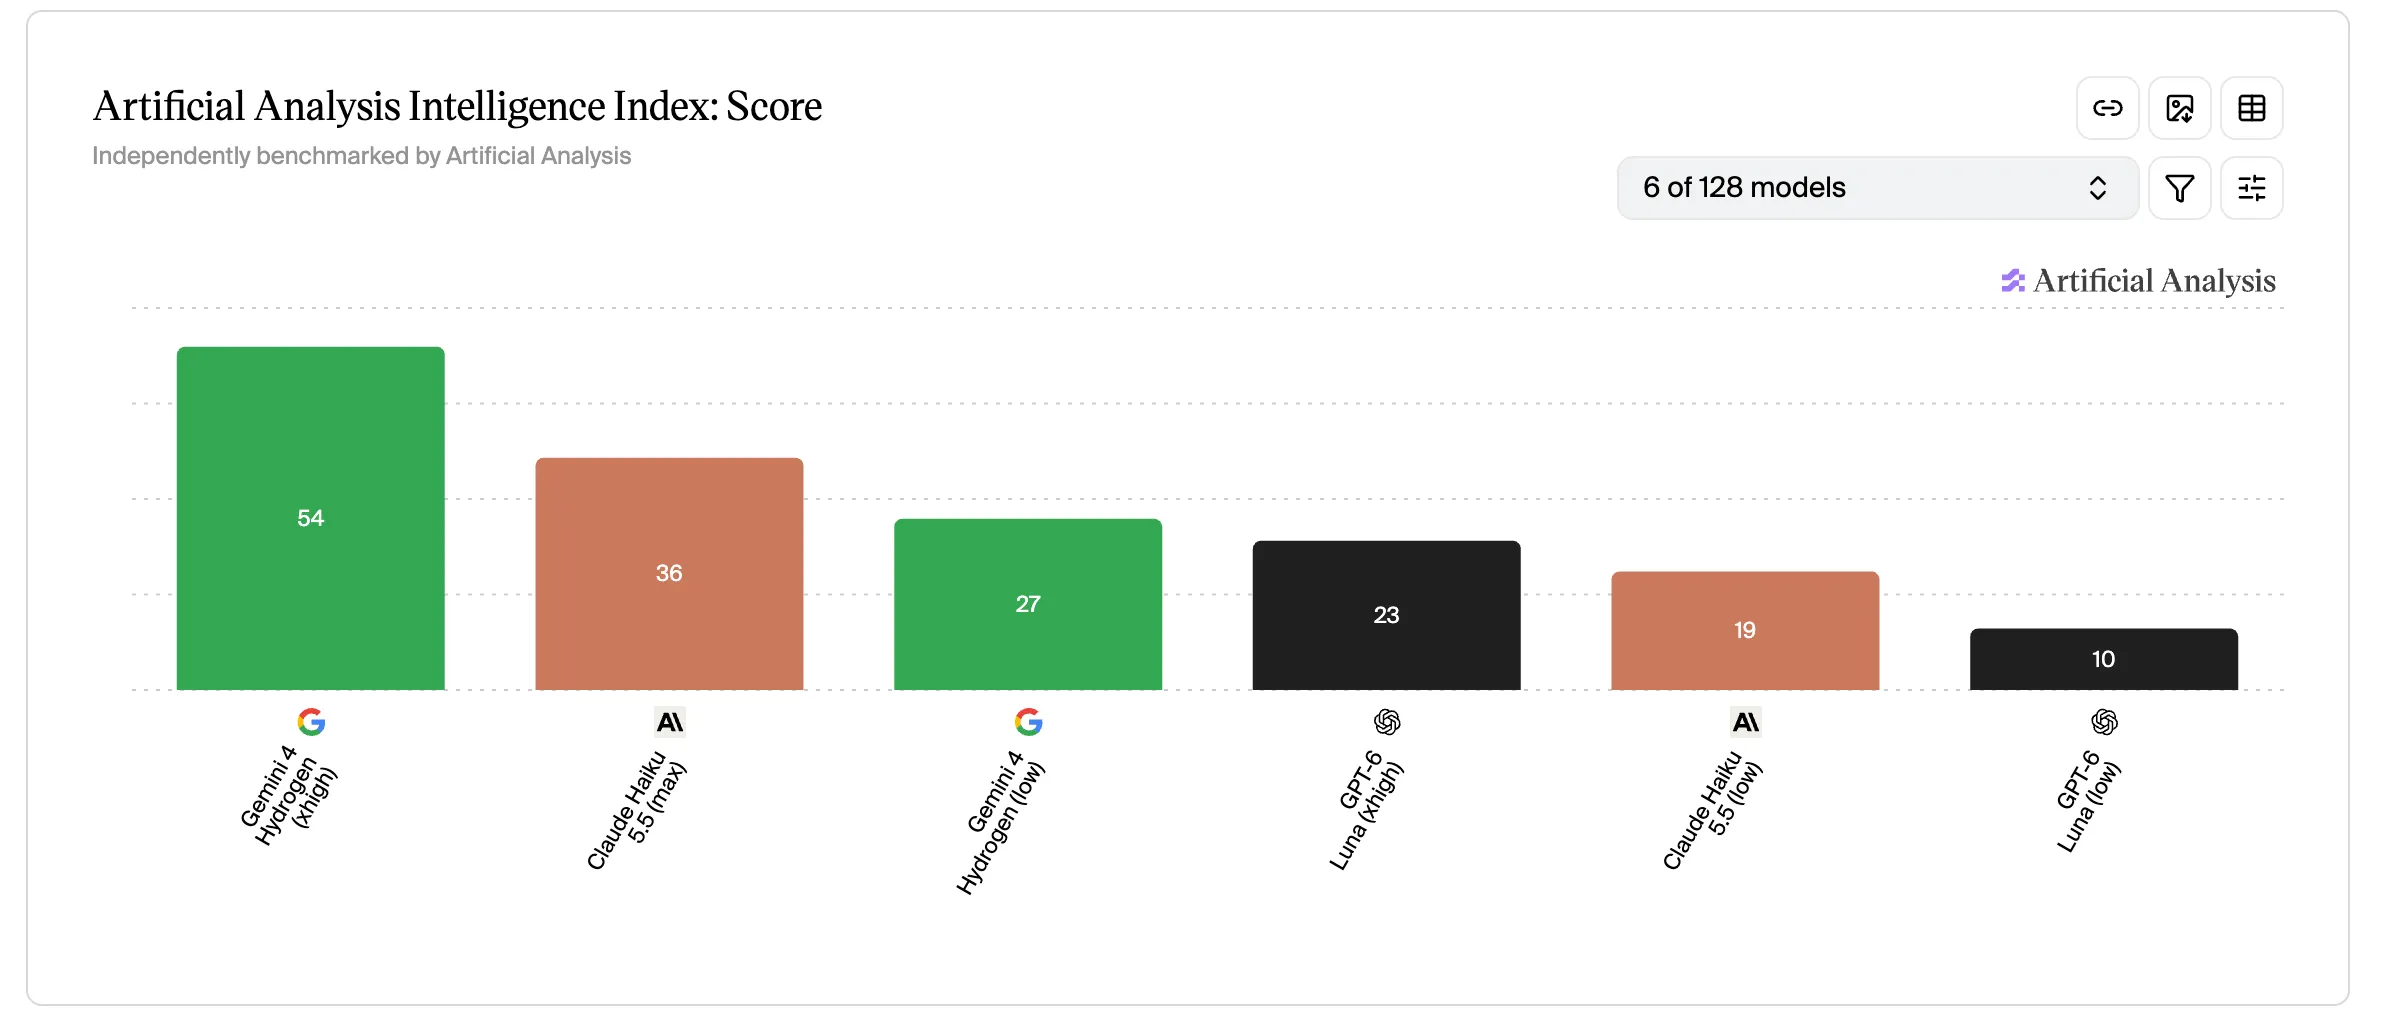
En réduisant le thinking pour tenir les contraintes du temps réel, les scores d’intelligence chutent environ de moitié. Concrètement, on recule de six mois à un an en capacité brute de raisonnement.
4. Racheter cette intelligence avec le prompt optimization
Une fois le thinking réduit pour protéger le TTFT, votre modèle n’a plus de longue chaîne de pensée interne pour rattraper une consigne floue à la volée. Ce qu’un modèle raisonneur devinait silencieusement devient soudain une règle oubliée ou une réponse hors-piste.
Regardez la différence sur un flux de réservation :
Vague (un modèle raisonneur s’en sort) : « Aide à replanifier le rendez-vous, respecte les règles de la clinique et évite les doublons. » Explicite (ce qu’il faut à un modèle sans thinking) : « Avant de confirmer un créneau, vérifie (1) que l’appelant a donné une date et une plage horaire, et (2) que le créneau figure dans
available_slots. Si un élément manque, pose une seule question courte au lieu de deviner. »
Si le modèle n’a plus le temps de réfléchir au moment de répondre, c’est votre prompt qui doit avoir fait ce travail en amont. Le prompt optimization devient alors de l’ingénierie à part entière :
- Construisez vos jeux d’évaluation (evals) à partir de vrais transcripts imparfaits : hésitations, corrections en milieu de phrase, bruit ambiant et règles métier contradictoires.
- Utilisez le metaprompting et des optimiseurs automatisés — comme
MetaPromptOptimizeretGepaPromptOptimizerdans MLflow GenAI — pour durcir votre system prompt face à ces cas limites plutôt que de bricoler à l’intuition.
5. Grappiller chaque tour avec la génération préemptive (sans effets de bord)
Même avec un modèle rapide et un prompt ciselé, attendre la détection officielle de fin de phrase laisse filer de précieux dixièmes de seconde.
La génération préemptive (preemptive generation) comble cet écart en lançant l’inférence sur les transcriptions partielles, avant même que l’humain ait fini de parler. S’il termine sa phrase comme prévu, votre premier token est déjà prêt.
Le revers de la médaille, c’est que les humains changent d’idée en parlant :
« Je veux réserver le 18 janvier, euh… non, plutôt le 18 février. »
Dès que la transcription finale diverge du brouillon spéculatif, il faut pouvoir jeter proprement la génération périmée et relancer sur la phrase confirmée. Surtout, appliquez une règle d’or : ne laissez jamais une passe spéculative déclencher d’effet de bord irréversible. Spéculez sur la formulation ou sur une lecture sans risque, jamais sur une confirmation de réservation, une écriture en base de données ou un paiement.
6. Sortir les tool calls de l’agent qui parle
Rien ne casse plus vite le rythme d’un appel que de demander au LLM conversationnel d’exécuter ses propres tool calls (consultation CRM, vérification d’agenda, requête en base de données).
Dans une boucle mono-agent, chaque appel d’outil coince l’appelant derrière deux allers-retours d’inférence complets plus la latence réseau de votre API, le tout dans un silence absolu. Le premier tour décide d’appeler l’outil, le backend attend la réponse externe, puis un second tour génère enfin la réponse vocale.
Mono-agent bloquant
2 allers-retours LLM + attente API en silence
Orchestration découplée
La voix reste fluide pendant que les outils tournent
Le pattern éprouvé — formalisé par l’architecture Talker-Reasoner de Google DeepMind et pris en charge dans Pipecat (function calling asynchrone non bloquant et ParallelPipeline) comme dans LiveKit Agents — sépare les rôles autour d’un orchestrateur :
- L’agent qui parle garde le chemin critique et zéro tool call. Il reste léger, rapide, dédié au ton, au tour de parole et à la fluidité de l’échange.
- Des workers parallèles traitent les tâches lentes hors chemin critique. L’orchestrateur les lance en arrière-plan pendant que la discussion continue et réinjecte leurs résultats dans le contexte partagé dès qu’ils arrivent.
Voir l’orchestration multi-agents en direct
Une fois cet orchestrateur en place, rien ne vous limite à un seul worker. Sur un même tour de parole lors d’un appel de triage clinique, l’agent vocal maintient le lien pendant que l’orchestrateur lance en parallèle un worker de tool calling (agenda/CRM), un worker de diagnostic (drapeaux rouges) et un worker de recherche (protocoles internes) :
« J'ai de la fièvre depuis hier et je cherche un créneau demain matin. »
« D'accord, je note votre fièvre. Un instant, je vérifie les créneaux et protocoles… »
check_slots("demain_am") eval_symptoms(fièvre=24h) search_kb("protocole_fièvre") 3. Tool-Calling, Diagnostic et Recherche s'exécutent simultanément sans bloquer la conversation.
7. Tenir jusqu’à la vingtième minute avec la compaction asynchrone
Une démo de deux minutes ne fait presque jamais exploser une fenêtre de contexte. Un vrai appel de vingt minutes, oui.
Chaque aller-retour, hésitation et retour d’outil s’empile dans l’historique. Sans nettoyage, ce transcript qui gonfle vous pénalise doublement : le TTFT grimpe peu à peu à chaque tour (et le moindre cache miss coûte beaucoup plus cher), tandis que les modèles rapides à faible thinking finissent par perdre de vue les règles métier enfouies tout en haut du prompt.
Résumer les anciens échanges semble évident, sauf si vous le faites de manière synchrone : mettre l’appel en pause une ou deux secondes pour résumer recrée exactement le silence gênant que vous venez d’éliminer.
La solution s’appelle la compaction asynchrone du contexte, popularisée très tôt par Kwindla Hultman Kramer (créateur de Pipecat, notamment dans The TWIML AI Podcast #739 : « Building Voice AI Agents That Don’t Suck ») et intégrée dans l’auto-context summarization de Pipecat :
- Compacter hors du chemin critique. Dès que l’appel dépasse un budget de tokens ou un seuil de messages non résumés, déclenchez la compaction sur un worker en arrière-plan sans jamais bloquer la boucle audio.
- Remplacer l’historique proprement sans casser le fil. Reconstruisez la pile sous la forme
[System Prompt] + [Résumé compact des tours anciens] + [Derniers tours verbatim]. Garder le system prompt épinglé et les derniers échanges (ainsi que les appels d’outils en cours) intacts garantit une transition invisible pour l’appelant.
La vingtième minute reste ainsi aussi vive et rigoureuse que la première.
8. Survivre à une mauvaise journée : dompter le fallback et éviter le cache froid
Tôt ou tard, votre fournisseur principal connaîtra un après-midi difficile : latence qui dérive, rate limits ou panne partielle. Ajouter un modèle de secours (comme le FallbackAdapter de LiveKit) paraît trivial sur un schéma. En vocal en direct, un basculement naïf empire souvent la situation au pire moment.
Imaginez l’effet domino en cinq secondes :
- Le délai de détection : l’orchestrateur attend avant de conclure que le modèle primaire ne reviendra pas à temps.
- Le cold cache miss : la bascule s’opère en plein appel et envoie au modèle de secours votre system prompt complet plus tout l’historique pour la première fois. Son cache KV / prompt cache est complètement vide.
- La boucle de réinitialisation : ré-ingérer tout le contexte à froid fait exploser le TTFT. Le silence dépasse deux secondes. L’appelant lance « Allô ? », annule la génération, et tout repart à zéro.
- Modèle primaire Bloque / timeout
- Détection Silence gênant
- Cache froid (miss) Ré-ingère tout l'historique
- « Allô ? » Interruption → reset
- Dérive p95 Signal précoce
- Pré-chauffage Préfixe mis en cache
- Relais fluide TTFT bas + feedback vocal
N’attendez pas la panne franche pour présenter la conversation à votre modèle de secours. Surveillez les signaux précoces comme la dérive de latence en p95 et pré-réchauffez votre fallback en arrière-plan dès que le primaire commence à faiblir, afin que le préfixe de conversation soit déjà en cache avant la bascule réelle.
Bonus : rendre l’attente audible au téléphone — et visible à l’écran
Même avec l’architecture la plus affûtée, certaines étapes prennent un instant : un appel externe, une délégation de l’orchestrateur ou un transfert vers un spécialiste.
En vocal, la latence perçue compte autant que la latence réelle. Une seconde de silence inexpliqué paraît trois fois plus longue que deux secondes annoncées — et vos leviers dépendent du canal utilisé :
- Au téléphone (audio seul) : la voix est votre unique interface. Glissez un accusé de réception naturel avant une recherche longue (« Parfait, je vérifie les disponibilités à l’instant… ») et annoncez clairement les transferts (« Je vous passe notre spécialiste facturation »).
- Sur ordinateur ou dans une app web (audio + écran) : ne laissez jamais quelqu’un fixer une icône de micro figée pendant que trois workers travaillent en coulisses. Diffusez l’état en temps réel sur votre canal de données (WebRTC DataChannel ou WebSocket) :
- Afficher les vrais états du pipeline : distinguez Écoute, Transcription, Vérification de l’agenda, Recherche de protocoles et Réponse.
- Diffuser le transcript en direct : voir ses propres mots apparaître immédiatement rassure l’utilisateur qu’il a bien été compris, avant même la première syllabe synthétisée.
- Rendre les workers visibles : affichez une discrète pastille indiquant quel outil ou spécialiste a la main plutôt qu’un spinner générique.
La checklist avant de passer en production
| Chantier | Règle d'architecture | Ce que vous évitez |
|---|---|---|
| Réseau | WebRTC (UDP/Opus/AEC) côté client, WebSockets côté serveur | Head-of-line blocking TCP sur 4G ou Wi-Fi instable |
| Pipeline | STT → LLM → TTS + déclencheur sémantique si logique complexe | Agent speech-to-speech naturel mais fragile sur les règles |
| Modèle | Comparer avec thinking = low/off et prioriser le TTFT | Voix lente ou choix optimisé sur le mauvais benchmark |
| Prompts | Metaprompting + evals sur scénarios réels (ex. MLflow GenAI) | Oublis de consignes une fois le thinking désactivé |
| Préemptif | Amorcer sur les partiels, sans écriture spéculative | Réserver ou modifier un dossier sur une phrase corrigée |
| Tools | Isoler les tool calls dans des workers parallèles asynchrones | Deux allers-retours LLM bloquants avant de parler |
| Contexte | Compacter l'historique ancien en tâche de fond asynchrone | Hausse du TTFT et dérive des consignes sur les appels longs |
| Fallback | Surveiller la dérive p95 et pré-réchauffer le modèle de secours | Silence du cold cache miss et boucle d'interruption |
| UX & UI | Annoncer délais/transferts à voix haute et afficher état, transcripts et tools sur écran | Effet « Allô ? », UI figée et raccrochages prématurés |
Au fond, ces huit principes poursuivent un seul objectif : quand votre appelant demande à déplacer son rendez-vous de jeudi, il ne devrait jamais avoir à dire « Allô ? Vous êtes encore là ? » — et votre agent ne devrait jamais avoir à sacrifier son jugement pour répondre à temps.
Références et ressources
- Kwindla Hultman Kramer (Daily / Pipecat) — Voice AI & Voice Agents: An Illustrated Primer (budgets de latence, WebRTC vs WebSockets, détection de tour de parole, function calling, pipelines modulaires vs speech-to-speech) et The TWIML AI Podcast #739 : « Building Voice AI Agents That Don’t Suck » (orchestration, architectures modulaires et compaction asynchrone du contexte).
- Documentation Pipecat — docs.pipecat.ai (transports WebRTC/WebSocket, function calling asynchrone,
ParallelPipeline, détection Smart Turn et auto-context summarization). - Documentation LiveKit Agents — docs.livekit.io/agents/ (génération préemptive,
FallbackAdapter, Turn Detector, états d’agent côté UI et DataChannels WebRTC). - Google DeepMind (2024) — Agents Thinking Fast and Slow: A Talker-Reasoner Architecture (séparation entre l’agent conversationnel rapide et le raisonnement/appel d’outils asynchrone en arrière-plan).
- Artificial Analysis — artificialanalysis.ai (benchmarks TTFT, débit et Intelligence Index selon le niveau d’effort de thinking).
- MLflow GenAI — mlflow.org/docs/latest/genai/ (suites d’évaluation et optimisation de prompts via
MetaPromptOptimizeretGepaPromptOptimizer).